Cloud Services
CRM Lösungen
App Entwicklung
SEO

 Shopify
 Shopware Software Entwicklung
 TYPO3 Web Entwicklung
 WooCommerce
 WordPress
 Google Ads Online Marketing Performance Marketing
 SEO Social Media Marketing Video Produktion AdvertisingShopify Agentur Shopware Agentur Softwareentwicklung Agentur TYPO3 Agentur Webentwicklung Agentur WooCommerce Agentur WordPress Agentur
 .NET Core Agentur
 Angular Agentur AR / VR Agentur Blockchain Agentur DAM Agentur
 Drupal Agentur IoT-Anbieter
 Java Agentur
 Joomla Agentur
 Laravel Agentur Machine Learning Dienstleister
 Magento Agentur
 PHP Agentur Progressive Web App Agentur
 Python Agentur
 React Agentur
 Ruby on Rails Agentur
 SAP Partner
 Sharepoint Agentur
 Vue.js Agentur
 Webflow AgenturGoogle Ads Agentur Online Marketing Agentur Performance Marketing Agentur SEO Agentur Social Media Agentur Video-Agentur Werbeagentur Affiliate Agentur CRO-Agentur Direktmarketing Agentur E-Mail Marketing Agentur Event Marketing Agentur
 GEA Agentur GEO Agentur Inbound Marketing Agentur Instagram Agentur Lead-Agentur LinkedIn Agentur Marktforschung Agentur Mediaagentur Naming Agentur PPC Agentur PR Agentur SEM Agentur TikTok Agentur YouTube Agentur

Web: https://www.hanse-it-systeme.de/de/
FULL SERVICE IT-DIENSTLEISTER
Überlassen Sie Ihre IT-Aufgaben einem Profi:
Wir betreiben Ihre IT-Prozesse. Auf Wunsch komplett oder partiell, vor Ort oder Remote. Das sichert Ihnen ein Höchstmaß an Effizienz sowie Sicherheit - und reduziert Ihre Kosten. So wird Ihre IT-Infrastruktur besser und kostengünstiger werden.
IT-INFRASTRUKTUR LÖSUNGSKOMPETENZEN
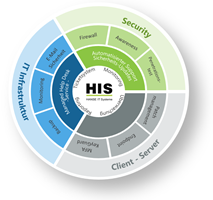
Bei IT-Projekten sind wir Ihr kompetenter Partner im Infrastruktur-Bereich Die HIS HANSE IT Systeme GmbH hat sich auf den Bereich IT Infrastrukturen spezialisiert und bietet Lösungen aus unterschiedlichen Bereichen an. Verschaffen Sie sich einen Überblick über unser Angebot.
MANAGED SERVICE
Vollgepackt mit Features, was will man mehr? Ihr Vorteil auf einen Blick:
IoT - LÖSUNGEN
Wofür brauchen Sie als Unternehmen eine IoT-Lösung?
Das Internet der Dinge eröffnet Unternehmen ungeahnte Perspektiven, es schafft Mehrwert für Ihre Kunden und Anwender. Daher ist die Auswahl eines Anwendungsfalls der erste Schritt auf dem Weg zu Ihrer IoT-Lösung, um Ihre Prozesse und Anwendungen im Arbeitsalltag zu verbessern.
Wir integrieren nicht nur Internet der Dinge (IoT) Technologie - unser Konzept basiert auf einer gesicherten Datenkommunikation und Vernetzung von der Betriebstechnik (OT) und Unternehmens-IT (IT). Dadurch entstehen Weiterentwicklungen und Verbesserungen bestehender Geschäftsprozesse bzw. Schaffung vollkommen neuer Geschäftsideen durch Nutzung von IoT-Daten und Analytics.
Erweitern Sie Ihre Wertschöpfungskette und bleiben bzw. werden Sie flexibel, skalierbar und wettbewerbsdifferenzierend. Unabhängig von Übertragungstechnologie und Herstellern unterstützen wir Sie bei der komplexen Herausforderung die richtige IoT Lösung zu finden.
Der Kunde wollte seine bestehende, heterogene IT‑Infrastruktur modernisieren, ohne in die Cloud ausweichen zu müssen. Die Unternehmensstrategie verlangte eine On‑Premises‑Lösung, die gleichzeitig zukunftssicher, skalierbar, einfach zu betreiben, ausfallsicher und optimal geschützt ist. Gemeinsam mit dem Service Provider wurde eine hyperkonvergente Infrastruktur (HCI) aufgebaut, die Server, Storage und Virtualisierung in einer integrierten Plattform vereint.
Kundenwunsch:
Der Kunde hatte mehrere kritische Punkte, die gelöst werden mussten:
Ergebnis: Selbst wenn Rechenzentrum A + Rechenzentrum B gleichzeitig ausfallen oder verschlüsselt werden, ist der Kunde in der Lage, innerhalb kürzester Zeit eine vollständige, isolierte Notfallumgebung hochzufahren.
Kontaktieren Sie den Anbieter und erhalten Sie zeitnah ein entsprechendes Angebot.